Mistral abre los pesos de Large 4: su modelo de un billón de parámetros, «Le Chonk», ya se puede descargar y autoalojar
No es un modelo nuevo, es la entrega que faltaba: el buque insignia de Mistral pasa de vista previa por API a pesos que cualquiera puede descargar, inspeccionar y correr en su propia infraestructura. La mejora grande no es de potencia bruta, es de eficiencia.
Mistral publicó este jueves 29 de octubre los pesos de Mistral Large 4, su modelo apodado Le Chonk. El modelo ya existía en vista previa desde el 6 de octubre, servido por API; lo nuevo es que su checkpoint completo se puede descargar desde Hugging Face, inspeccionarlo, ajustarlo y desplegarlo con vLLM o SGLang en infraestructura propia, además de seguir disponible en la API de Mistral, OpenRouter, Microsoft Foundry y endpoints de Nvidia.
La ficha es de modelo enorme pero disperso: 1,05 billones de parámetros totales en mezcla de expertos, de los que se activan unos 52.000 millones por token, con entrada de texto e imagen, contexto de un millón de tokens y entrenamiento desde cero en 3.800 GPU Grace Blackwell en Europa. Añade tres modos de razonamiento —bajo, medio y alto, este último por defecto— para ajustar coste y profundidad según la tarea.
Entre la vista previa y hoy hay tres semanas más de aprendizaje por refuerzo. Según Mistral, eso llevó su resultado en Terminal-Bench 4.0 del 28% al 41%, con un 30% menos de tokens de salida, y a un 48% en el Coding Agent Index de Artificial Analysis, prácticamente empatado con el líder abierto GLM-5.3 pero usando un 47% menos de tokens por tarea. En ciberseguridad defensiva, la compañía reporta un 51% en el Cyber Index de esa evaluadora y un rechazo medio del 96,6% a peticiones maliciosas.
La evaluación independiente matiza el titular y refuerza la parte económica. Artificial Analysis, según recoge VentureBeat hoy, da a la versión final 26 puntos en su Intelligence Index v5, uno por encima de Muse Spark Open: es el modelo de pesos disponibles desarrollado fuera de China mejor puntuado en esa medición, aunque sigue por detrás de los líderes abiertos chinos. Donde el salto sí es grande es en eficiencia: el coste medido por tarea bajó de 5,54 a 2,06 dólares, una caída del 63%, y la tasa de alucinación bajó del 41% al 28%.
La licencia define el negocio: es una MIT modificada que permite usar, modificar y comercializar el modelo, con una sola condición: quien opere un servicio de modelos para terceros necesita una licencia comercial aparte. La API también bajó, a 0,70 dólares por millón de tokens de entrada y 2,10 por millón de salida. La apuesta es clara: frente a los modelos cerrados, vender control —un modelo casi puntero que una empresa puede poseer y auditar—.
Comentarios
Sé el primero en comentar.
Sigue leyendo
 Hardware · IA
La prueba estaba en los pesos: los grandes modelos chinos llevan la huella de las Blackwell de Nvidia vetadas para China
Los pesos de DeepSeek, Kimi, MiniMax y Ant Group guardan la firma de las GPU Blackwell vetadas para China sin licencia de EE. UU. ¿Cómo accedieron a ellas?
 IA
Gemini ya puede leer tu banco: Google conecta Wallet a su IA para analizar tus gastos
Gemini ya puede mirar tus cuentas vía Wallet y Plaid para analizar gastos y cazar suscripciones caras. Solo lee, no paga: ¿le abrirías tu banco a la IA?
 IA
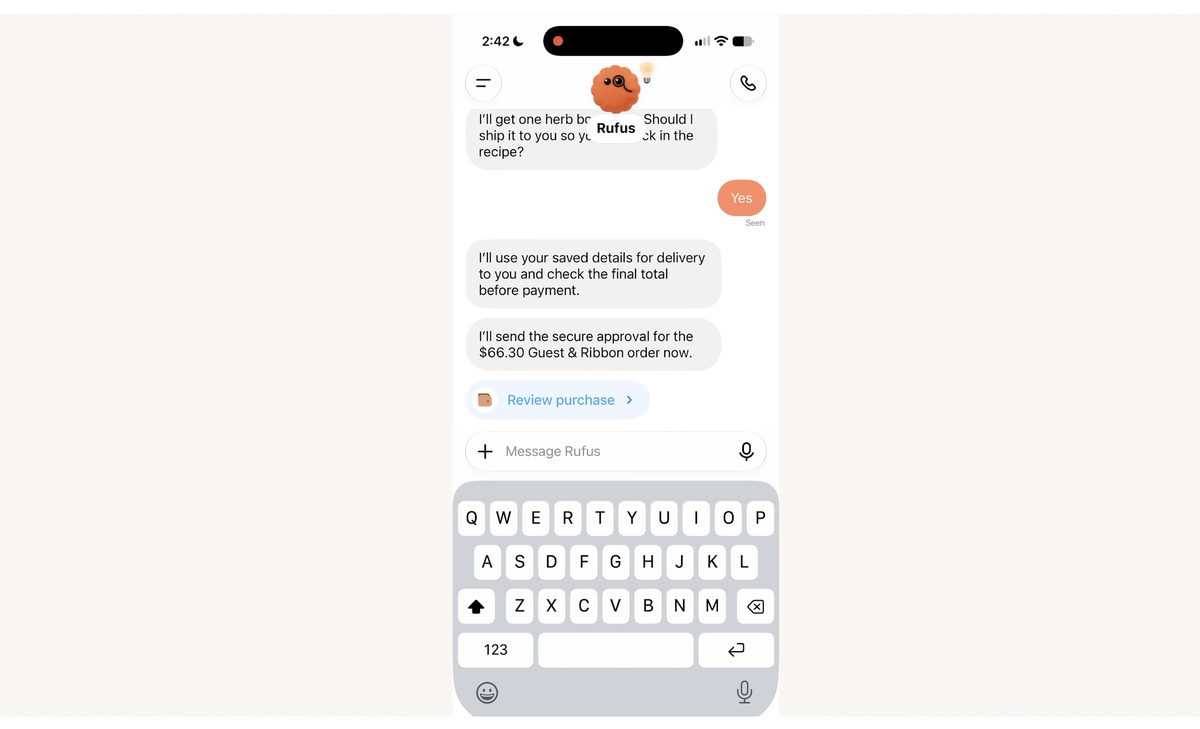
ChatGPT ya puede pagar por ti: OpenAI lanza Wallet y sus agentes compran con tu aprobación
OpenAI ya deja que su agente pague por ti: revisas el pedido, apruebas con Face ID y tu tarjeta real nunca se comparte. ¿Le darías tu cartera a un dot?