Meta lanza Muse Ember, su modelo más barato para agentes: iguala a Haiku 5.5 por un tercio del coste por tarea
El modelo grande piensa y el pequeño ejecuta: Ember nace para hacer miles de veces al día el trabajo repetido de los agentes, a 0,10 dólares el millón de tokens de entrada.
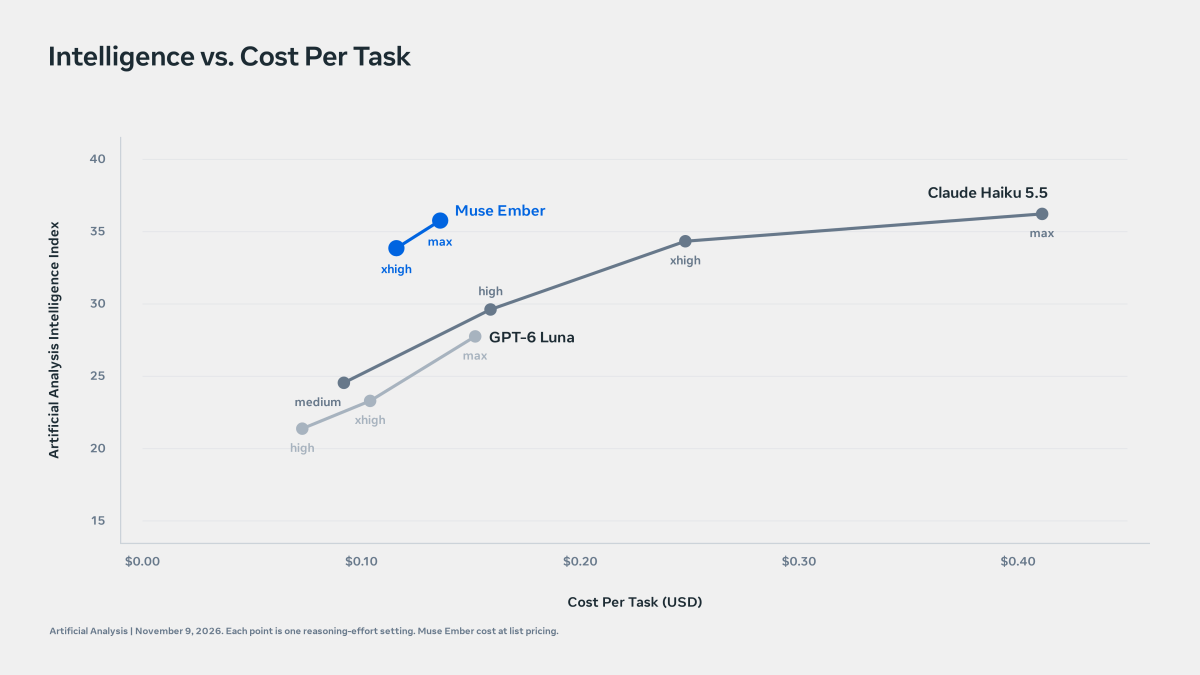
Meta ya no compite solo por el modelo más potente: compite por el más barato. Meta Superintelligence Labs ha lanzado este lunes Muse Ember, su modelo más pequeño y eficiente, pensado para el trabajo que los agentes repiten todo el día: llamadas a herramientas, subtareas de código, enrutado, extracción de datos y análisis de documentos largos.
La cifra que manda es el precio. Ember cuesta 0,10 dólares por millón de tokens de entrada —0,004 dólares si la entrada está en caché— y 0,50 dólares por millón de salida, ya disponible en Muse Code y en la Meta Model API como muse-ember-1.0. Su ventana llega a 1 millón de tokens, con hasta 512.000 de salida: suficiente, según Meta, para tragarse una base de código o un conjunto completo de documentos en una sola llamada.
La comparación que Meta pone sobre la mesa es directa. En el Artificial Analysis Intelligence Index, Ember alcanza 36 puntos en su ajuste máximo, prácticamente empatado con Claude Haiku 5.5 (36,2) y por encima de GPT-6 Luna (28), pero a un coste estimado de unos 0,14 dólares por tarea frente a los 0,411 dólares de Haiku: cerca de un tercio. En AutomationBench-AA marca 37,8 %, frente al 13,9 % de Haiku y el 20,2 % de Luna. Son cifras publicadas por Meta a partir de Artificial Analysis y de evaluaciones propias, pendientes de reproducción fuera de su laboratorio.
El diseño es de equipo, no de estrella solitaria. Meta lo resume en una frase: «Muse Wonder plans, Muse Ember handles the volume» —Wonder planifica y Ember asume el volumen—. Ember es además el primer modelo entrenado usando Muse Wonder Full como maestro, y es multimodal nativo: entiende texto, imágenes, audio y vídeo, de modo que un agente puede leer capturas, gráficos y documentos escaneados, o trabajar desde notas de voz y grabaciones sin llamar a un segundo modelo.
Antes de lanzarlo, Meta lo evaluó bajo su Meta Superintelligence Scaling Framework —riesgos químicos y biológicos, ciberseguridad y pérdida de control— y afirma que se mantuvo por debajo de los umbrales de alto riesgo. Es el cuarto modelo de la familia Muse, tras Spark en abril, Glimmer en agosto y Wonder en octubre. La apuesta es clara: si los agentes ejecutarán millones de pasos al día, el negocio está en el modelo que puede ejecutar sin arruinar la factura.
Comentarios
Sé el primero en comentar.
Sigue leyendo
 Hardware · IA
La prueba estaba en los pesos: los grandes modelos chinos llevan la huella de las Blackwell de Nvidia vetadas para China
Los pesos de DeepSeek, Kimi, MiniMax y Ant Group guardan la firma de las GPU Blackwell vetadas para China sin licencia de EE. UU. ¿Cómo accedieron a ellas?
 IA
Gemini ya puede leer tu banco: Google conecta Wallet a su IA para analizar tus gastos
Gemini ya puede mirar tus cuentas vía Wallet y Plaid para analizar gastos y cazar suscripciones caras. Solo lee, no paga: ¿le abrirías tu banco a la IA?
 IA
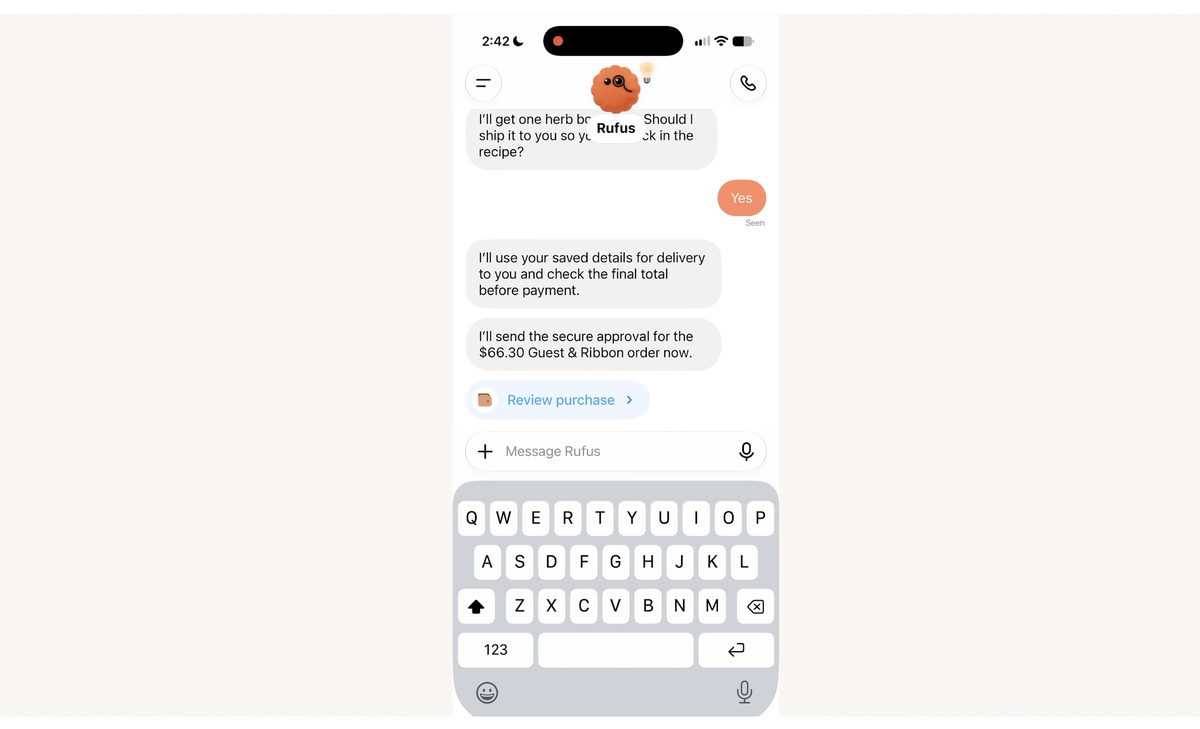
ChatGPT ya puede pagar por ti: OpenAI lanza Wallet y sus agentes compran con tu aprobación
OpenAI ya deja que su agente pague por ti: revisas el pedido, apruebas con Face ID y tu tarjeta real nunca se comparte. ¿Le darías tu cartera a un dot?